Semantika
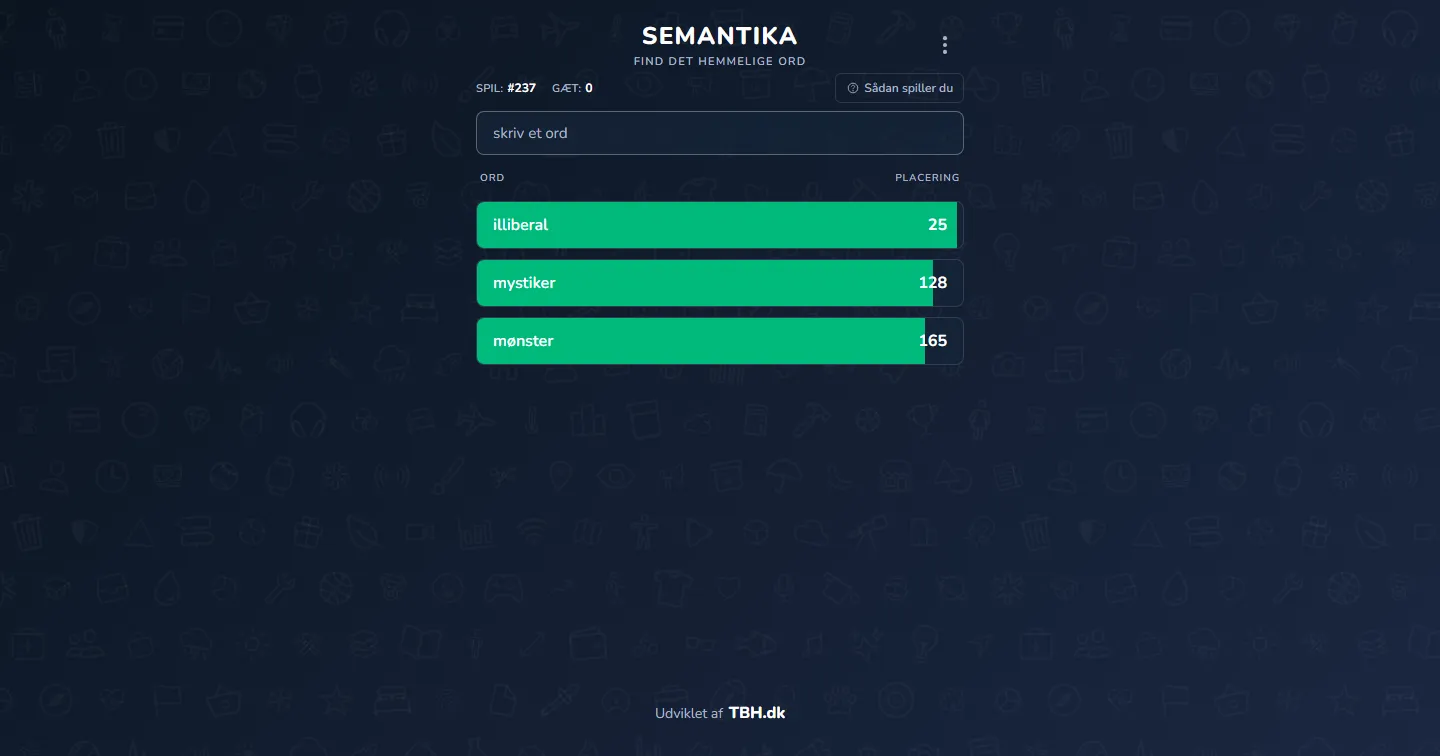
Semantika er et dansk ordgættespil, hvor du finder det hemmelige ord ud fra betydning i stedet for bogstaver.
- Status
- Live
- Adresse
- semantika.dk
- Stack
- Next.js · TypeScript · Turso · Word2Vec
I tal
- 88.502
- Ord du kan gætte
- 5.831
- Unikke baner
- 1,4M
- Ordvektorer
Sådan virker det
Hvert gæt får en rangering. Det hemmelige ord har rangering 1, og jo lavere tal, jo tættere er du på. Rangeringen kommer fra cosine similarity mellem ordvektorer.
Eksempel: det hemmelige ord er "kat"
Rangeringen afspejler, hvor ofte ord optræder i lignende sammenhænge i danske tekster, og kan derfor afvige fra logiske kategorier.
AI-modellen
Semantisk lighed beregnes med en dansk Word2Vec-model (DSL Skipgram 2020) trænet på et stort korpus af danske tekster fra Det Danske Sprog- og Litteraturselskab. Modellen konverterer hvert ord til en 500-dimensionel vektor, hvor geometrisk nærhed afspejler semantisk lighed.
Rangeringen bruger en best-inflection-strategi: hvert ord sammenlignes med målordet i alle sine bøjningsformer (fx "rotte", "rotten", "rotter"), og den højeste lighed afgør rangeringen. Det fanger betydninger, som grundformen alene kan overse.
Ordlister
Gæt-ordforråd (~88.500 ord)
Bygget på lemmalisten fra DDO (Den Danske Ordbog) og filtreret med en blokeringsliste, der fjerner bandeord og stødende eller upassende ord. Kun ord med en Word2Vec-vektor er med.
Målord / baner (5.831 ord)
En delmængde, filtreret til navneord via DanNet. Ord, der er for abstrakte, kontroversielle eller obskure, er fjernet.
Lemmatisering
Bøjningsformer som "katte", "katten" og "kattene" føres tilbage til lemmaet "kat".
Designvalg
Turso frem for Supabase
Semantikas data er read-heavy: ~90.000 ord med forudberegnede rangeringer. Turso (libSQL) kører edge-replicas tæt på brugeren med sub-millisekund reads, og ved vores volumen er det gratis. Supabase ville give os mere infrastruktur, end vi har brug for, og langsommere cold starts.
Word2Vec frem for moderne embeddings
Transformer-baserede modeller (BERT, GPT) giver kontekstafhængige vektorer: det samme ord kan have forskellige vektorer i forskellige sætninger. Word2Vec giver én fast vektor pr. ord og dermed den deterministiske rangering, spillet bygger på. DSL's Word2Vec-model er desuden lavet til dansk og dækker 1,4 mio. ord.
Forudberegnede rangeringer
Alle rangeringer er forudberegnet og gemt i databasen, så et gæt er et opslag i stedet for en beregning af cosine similarity over 88.000 ord (O(n)). Browseren modtager kun rangeringen for hvert gæt.
Sammensatte ord
Dansk er rigt på sammensætninger ("samarbejdsaftale" for "aftale"). Uden justering ville de dominere toppen af rangeringen. Løsningen er en proportional straf: sammensatte ord bliver i rangeringen, men rykker ned, så semantisk relevante ord kommer først.
Datakilder
Teknologi
Prøv spillet selv
Spil SemantikaNæste projekt
Nordvec